Durante años, el parser de Google fue deliberadamente permisivo con el JSON-LD. Sabía que buena parte de la web genera datos estructurados con plantillas, plugins y concatenaciones de cadenas que producen código sintácticamente sucio, y decidió limpiar en varias pasadas antes de interpretar. Esa tolerancia sostuvo silenciosamente los resultados enriquecidos de muchísimos sitios que técnicamente estaban emitiendo JSON inválido.
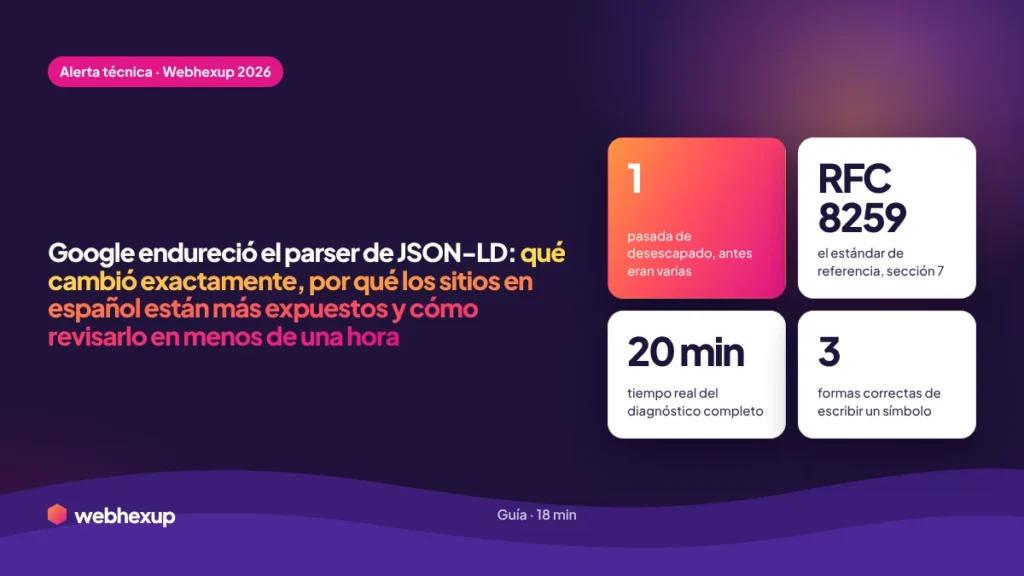
Esa etapa se acabó. Google anunció que ajustó su extracción de JSON-LD para aplicar una única pasada de desescapado de HTML, con el objetivo explícito de alinear el parser con el estándar. Gary Illyes remitió al RFC 8259, sección 7, que es donde el estándar define exactamente qué es un escapado correcto en JSON.
Para la mayoría de sitios esto no cambia nada. Para una minoría concreta, cambia bastante. Este artículo explica exactamente qué se rompió, cómo saber en veinte minutos si te afecta, por qué el riesgo es mayor en sitios en español, y cómo corregirlo según la plataforma que uses.
Qué cambió exactamente
y qué es el doble escapado.
Para entender el problema hay que separar dos capas que conviven en la misma página y que se confunden constantemente: la capa HTML y la capa JSON.
Tu JSON-LD vive dentro de una etiqueta script en un documento HTML. Eso significa que el contenido pasa por dos sistemas de escapado distintos, con reglas distintas, y cada uno tiene su propia forma de representar caracteres especiales. Cuando una plantilla aplica el escapado de HTML sobre un contenido que ya venía escapado, se produce el doble escapado.
Cómo se ve el problema
Tomemos el nombre de una firma legal colombiana real como ejemplo: Fernández & Asociados. El símbolo intermedio es el que causa todo el problema.
El parser anterior desescapaba repetidamente hasta llegar al carácter limpio. El parser actual desescapa una vez y entrega lo que quede, aunque siga siendo una entidad sin resolver.
El mismo caso en código
Así se ve el marcado que rompe y el marcado que funciona. Fíjate únicamente en el campo del nombre:
// INCORRECTO · entidad HTML dentro del valor JSON
{
  "@type": "LegalService",
  "name": "Fernández & Asociados",
  "description": "Defensa penal & corporativa en Medellín"
}

// CORRECTO opción 1 · carácter directo en UTF-8
{
  "@type": "LegalService",
  "name": "Fernández & Asociados",
  "description": "Defensa penal & corporativa en Medellín"
}

// CORRECTO opción 2 · escape Unicode hexadecimal
{
  "@type": "LegalService",
  "name": "Fernández \u0026 Asociados",
  "description": "Defensa penal \u0026 corporativa en Medellín"
}
Las dos opciones correctas producen exactamente el mismo resultado al interpretarse. La segunda es preferible cuando el JSON pasa por varias capas de plantillas, porque la barra invertida no vuelve a escaparse como HTML.
Los otros caracteres que suelen romper
| Carácter | Forma incorrecta frecuente | Forma correcta directa | Escape Unicode |
|---|---|---|---|
| Ampersand | & | & | \u0026 |
| Comilla doble | " | \" | \u0022 |
| Comilla simple | ' | ' | \u0027 |
| Menor que | &lt; | < | \u003C |
| Mayor que | &gt; | > | \u003E |
| Check | &#10004; | ✓ | \u2713 |
| Espacio duro | &nbsp; | espacio normal | \u00A0 |
A quién afecta:
matriz de riesgo por configuración.
El riesgo no es uniforme. Depende casi por completo de cómo se genera el JSON-LD en tu sitio, no del tamaño del sitio ni del sector. Esta es la matriz que uso para clasificar clientes cuando llega un cambio de este tipo:
| Configuración | Riesgo | Por qué |
|---|---|---|
| Yoast o Rank Math sin personalizar | Bajo | Generan el JSON con funciones de serialización nativas que escapan correctamente |
| JSON-LD escrito a mano en HTML plano | Bajo | Control total sobre cada carácter, sin capas intermedias |
| Shopify con plantillas Liquid | Medio | Depende de si se aplicó un filtro de escapado de HTML sobre el valor |
| Elementor con widget HTML personalizado | Medio | Depende de cómo se pegó el código y de si el editor lo reescribió |
| Plugin de schema con campos de texto libre | Medio alto | El texto que pega el usuario puede traer entidades desde otro editor |
| JSON-LD generado por PHP con función de escapado HTML | Alto | El doble escapado es prácticamente automático si se aplica sobre el valor |
| Headless con inyección directa de HTML | Alto | Depende enteramente del serializador y de cómo se inserte en el documento |
| Contenido migrado desde otro CMS | Alto | Las migraciones arrastran entidades HTML dentro de los campos de base de datos |
El patrón que genera casi todos los casos graves
En mi experiencia revisando desarrollos a medida, el origen del problema suele ser el mismo: alguien aplicó una función de escapado de HTML sobre un valor que va a ir dentro de un JSON, por precaución de seguridad, sin darse cuenta de que el contexto no es HTML sino JSON.
// PHP · patrón que produce doble escapado
$nombre = "Fernández & Asociados";
$json = '{"name": "' . htmlspecialchars($nombre) . '"}';
// resultado: {"name": "Fernández &amp; Asociados"}
// PHP · patrón correcto
$datos = ["name" => "Fernández & Asociados"];
$json = json_encode($datos, JSON_UNESCAPED_UNICODE | JSON_HEX_AMP);
// resultado: {"name":"Fernández \u0026 Asociados"}La regla general es no construir JSON concatenando cadenas. Usa siempre la función de serialización del lenguaje, que conoce las reglas de escapado del formato y las aplica correctamente.
Por qué los sitios en español
están más expuestos.
Esta sección no la vas a encontrar en las coberturas en inglés del anuncio, y es la que más me preocupa como consultor trabajando el mercado hispanohablante. Hay tres razones concretas por las que nuestro riesgo es mayor.
Razón 1 · Los nombres comerciales con ampersand son mucho más frecuentes
En el mundo hispanohablante, y muy especialmente en servicios profesionales, la construcción con ampersand es la norma para firmas de abogados, contadores, arquitectos y consultoras. Fernández & Asociados, Muñoz & Cía, Restrepo & Hermanos. Ese carácter es exactamente el que dispara el problema, y aparece en el campo más importante del marcado: el nombre de la organización.
Un sitio en inglés de comercio electrónico puede pasar años sin un solo ampersand en su JSON-LD. Un directorio de despachos jurídicos colombianos lo tiene en cada ficha.
Razón 2 · Las migraciones desde CMS antiguos arrastran entidades de caracteres acentuados
Buena parte del parque web latinoamericano viene de migraciones desde sistemas antiguos que almacenaban los caracteres acentuados como entidades HTML nombradas en lugar de UTF-8. Cuando ese contenido pasa a un campo que después se serializa a JSON, y encima se le aplica un escapado adicional, aparece el doble escapado sobre caracteres que en inglés simplemente no existen.
// Cadena migrada desde CMS antiguo
"description": "Especialistas en derecho penal en Medell&iacute;n"
// Lo que ve Google tras una sola pasada
"description": "Especialistas en derecho penal en Medellín"
// Lo correcto en UTF-8
"description": "Especialistas en derecho penal en Medellín"La eñe, las vocales acentuadas y la diéresis son los caracteres que más aparecen mal codificados en contenido migrado. En inglés este vector de riesgo es prácticamente inexistente.
Razón 3 · Los signos de apertura son un caso especial poco documentado
El signo de apertura de interrogación y el de exclamación no existen en inglés, así que ninguna guía en ese idioma advierte sobre ellos. En marcado de preguntas frecuentes, donde cada pregunta empieza con el signo de apertura, un pipeline que los convierta a entidades y después escape otra vez produce el problema en absolutamente todas las preguntas del bloque.
Si usas marcado de preguntas frecuentes en español, ese bloque concentra más caracteres de riesgo que cualquier otro de tu sitio, y es además uno de los que más resultados enriquecidos genera históricamente.
Cómo diagnosticarlo
en tu sitio paso a paso.
Este es el procedimiento que sigo, ordenado de más rápido a más exhaustivo. Los primeros tres pasos toman veinte minutos y detectan la mayoría de los casos.
Mira el código fuente crudo, no el inspector
Abre una página con marcado y usa la opción de ver código fuente del navegador, no las herramientas de desarrollador. El inspector muestra el DOM ya procesado y puede resolverte visualmente entidades que en el archivo servido siguen presentes. Es el error de diagnóstico más común y hace que la gente concluya que está limpia cuando no lo está.
Busca dentro del bloque de script las cadenas con ampersand seguido de letras y punto y coma. Si aparece una entidad HTML dentro de un valor de texto del JSON, tienes el problema.
Pasa el bloque por un validador de JSON puro
Copia únicamente el contenido entre las etiquetas de script y pégalo en cualquier validador de JSON estándar. Este paso es distinto de validar el schema: aquí no te interesa si los tipos son correctos, sino si el JSON es sintácticamente válido según el estándar.
Un bloque puede pasar la validación de schema y aun así contener valores con entidades sin resolver, porque son cadenas sintácticamente válidas que simplemente contienen texto equivocado.
Usa la Prueba de Resultados Enriquecidos y lee los valores extraídos
Esta es la verificación decisiva, porque te muestra exactamente qué está leyendo Google. No mires solo si dice que la página es apta: entra a los valores y verifica que el nombre de la organización, las preguntas y las descripciones se lean limpias.
Si en el panel de valores extraídos aparece una entidad sin resolver, ese es exactamente el texto que Google va a usar, y el que puede aparecer en un resultado enriquecido si llega a mostrarse.
Revisa el informe de mejoras en Search Console
Entra a la sección de mejoras y revisa cada tipo de resultado enriquecido que tengas activo. Presta atención especial a la evolución de los últimos días, porque un cambio de parser se manifiesta como una caída escalonada en elementos válidos, no como un error puntual.
Usa también la inspección de URL sobre páginas representativas de cada plantilla, no solo sobre la portada. Los problemas suelen concentrarse en un tipo de plantilla concreto.
Rastrea el sitio completo y extrae todos los bloques
Para sitios grandes, configura una extracción personalizada en tu rastreador que capture el contenido de las etiquetas de script de tipo JSON-LD en todas las URL. Exporta y busca el patrón de entidad dentro de la columna extraída con una expresión regular sencilla.
Este paso convierte una revisión manual imposible en una lista concreta de URL afectadas, agrupables por plantilla.
Cómo corregirlo
según tu plataforma.
WordPress con Yoast o Rank Math
Si no has personalizado la salida, no deberías tener problema: ambos generan el JSON con funciones de serialización nativas. El riesgo aparece cuando hay filtros personalizados que modifican la salida o cuando el campo de texto trae entidades desde la base de datos.
// Filtro peligroso que puede introducir doble escapado
add_filter('wpseo_schema_organization', function($data) {
    $data['name'] = esc_html(get_bloginfo('name'));
    return $data;
});

// Versión correcta: sin escapado HTML adicional
add_filter('wpseo_schema_organization', function($data) {
    $data['name'] = html_entity_decode(
        get_bloginfo('name'),
        ENT_QUOTES,
        'UTF-8'
    );
    return $data;
});
La función de decodificación de entidades antes de entregar el valor al generador de schema resuelve el problema en origen, incluso si el dato viene sucio de la base de datos.
JSON-LD pegado en un widget HTML de Elementor
Es el caso que más veo en sitios construidos con constructores visuales, y el diagnóstico es sencillo: el editor puede reescribir caracteres al guardar. Verifica siempre el código fuente servido después de guardar, no el que ves en el editor.
Si detectas que el editor está transformando los caracteres, la solución más robusta es usar escapes Unicode hexadecimales en lugar de caracteres directos, porque la barra invertida no se reescribe como entidad.
Desarrollo a medida en PHP
La regla es una sola y no admite excepciones: nunca construyas el JSON concatenando cadenas.
// Construcción segura con banderas explícitas
$schema = [
    "@context" => "https://schema.org",
    "@type"    => "LegalService",
    "name"     => "Fernández & Asociados",
    "address"  => [
        "@type"           => "PostalAddress",
        "addressLocality" => "Medellín",
        "addressCountry"  => "CO"
    ]
];

echo '<script type="application/ld+json">';
echo json_encode(
    $schema,
    JSON_UNESCAPED_SLASHES | JSON_UNESCAPED_UNICODE | JSON_HEX_TAG | JSON_HEX_AMP
);
echo '</script>';
Las dos últimas banderas convierten los caracteres problemáticos a su forma Unicode hexadecimal, lo que evita cualquier conflicto con el escapado de HTML del documento contenedor. Es la configuración que uso por defecto en todos los desarrollos.
Shopify con plantillas Liquid
El error habitual es aplicar el filtro de escapado sobre el valor. La forma correcta es usar el filtro de serialización a JSON, que aplica las reglas del formato correcto.
// Incorrecto: escapa como HTML dentro de un contexto JSON
"name": "{{ product.title | escape }}"

// Correcto: serializa según las reglas de JSON
"name": {{ product.title | json }}
Nota que en la versión correcta no se escriben las comillas manualmente: el filtro de serialización las incluye. Es un cambio pequeño con efecto grande.
Entornos con JavaScript o headless
Serializa el objeto completo con la función nativa del lenguaje e insértalo sin transformaciones adicionales. Si el framework aplica escapado automático al insertar en el documento, usa la vía explícita que el framework provee para contenido ya serializado, y verifica el resultado en el HTML servido, no en el componente.
Checklist de prevención
permanente.
Corregir el problema de hoy sirve poco si el pipeline lo va a volver a generar la próxima vez que alguien edite una ficha. Estas son las siete reglas que dejo escritas en la documentación técnica de cada cliente con desarrollo a medida:
- Nunca construir JSON concatenando cadenas. Siempre usar la función de serialización del lenguaje.
- Nunca aplicar funciones de escapado de HTML sobre valores que van dentro de un JSON. El contexto es JSON, no HTML.
- Preferir escapes Unicode hexadecimales cuando el marcado atraviesa varias capas de plantillas.
- Verificar siempre el código fuente crudo servido, nunca el DOM del inspector ni el editor visual.
- Incluir la validación de datos estructurados en el proceso de publicación, no solo en auditorías trimestrales.
- Limpiar las entidades HTML en el momento de la migración de contenido, no dejarlas para después.
- Revisar el informe de mejoras de Search Console con periodicidad mensual, para detectar caídas escalonadas antes de que se acumulen.
Una nota sobre proporción
Quiero cerrar con esto porque el tono de urgencia en redes puede desbordarse. Este cambio no es una penalización, no es una actualización de algoritmo y no afecta posiciones. Afecta la elegibilidad para resultados enriquecidos en las páginas cuyo marcado dependía de una tolerancia que Google decidió retirar.
Para la mayoría de sitios que usan generadores estándar, la revisión va a confirmar que todo está bien y no habrá nada que hacer. Para sitios con desarrollo a medida, marcado inyectado manualmente o historial de migraciones, la revisión vale mucho la pena y se hace en una tarde.
La lectura de fondo, que va más allá de este cambio puntual, es que la era de la tolerancia de los parsers se está cerrando en todos los frentes. Un marcado sintácticamente correcto ya no es una buena práctica opcional, es el requisito mínimo para participar. Y con los sistemas de IA leyendo cada vez más contenido estructurado para fundamentar respuestas, la calidad técnica de tu marcado tiene más consecuencias que nunca. Ese contexto lo desarrollo en la guía AI Visibility 2026 desde Colombia.
Preguntas frecuentes
sobre el cambio del parser.
¿Qué cambió exactamente en el parser de JSON-LD de Google?
Google modificó su extracción de datos estructurados en formato JSON-LD para aplicar una sola pasada de desescapado de HTML, en lugar de las varias pasadas que aplicaba antes. El objetivo declarado fue alinear el parser con el estándar oficial de JSON definido en el RFC 8259, cuya sección 7 especifica exactamente qué constituye un escapado correcto. En la práctica, las entidades con doble escapado ya no se resuelven.
¿Qué es el doble escapado en datos estructurados?
Ocurre cuando una entidad HTML se escapa de nuevo, quedando anidada dentro del valor de una cadena JSON. Sucede típicamente cuando una plantilla aplica una función de escapado de HTML sobre un texto que ya contenía entidades, o cuando se construye el JSON concatenando cadenas en lugar de usar la función de serialización del lenguaje.
¿Este cambio afecta mis posiciones en Google?
No. No es una actualización de algoritmo ni una penalización, y no afecta el posicionamiento orgánico. Afecta la elegibilidad para resultados enriquecidos: estrellas de valoración, precios, preguntas frecuentes, migas de pan y otros elementos visuales que dependen de que el marcado se interprete correctamente.
¿Cómo escribo correctamente un ampersand dentro del JSON-LD?
Hay dos formas válidas. La primera es el carácter directo en codificación UTF-8, escribiendo simplemente el símbolo. La segunda es el escape Unicode hexadecimal nativo de JSON, que se escribe como barra invertida seguida de u y el código hexadecimal correspondiente. Lo que debe evitarse es la entidad HTML dentro del valor JSON.
¿Cómo sé si mi sitio está afectado?
El diagnóstico más rápido toma veinte minutos: mira el código fuente crudo de la página buscando entidades dentro de los bloques de script, pasa el bloque por un validador de JSON estándar y usa la Prueba de Resultados Enriquecidos revisando los valores extraídos y no solo el veredicto de aptitud. Complementa con el informe de mejoras de Search Console para ver la evolución de los últimos días.
¿Por qué los sitios en español están más expuestos?
Por tres razones. Primera, los nombres comerciales con ampersand son mucho más frecuentes en servicios profesionales hispanohablantes, y ese es el carácter que dispara el problema. Segunda, buena parte del parque web latinoamericano viene de migraciones que arrastraron caracteres acentuados y eñes almacenados como entidades HTML. Tercera, los signos de apertura de interrogación y exclamación no existen en inglés, así que ninguna guía en ese idioma advierte sobre ellos, y concentran riesgo en los bloques de preguntas frecuentes.
¿Uso Yoast o Rank Math, tengo que hacer algo?
Si no has personalizado la salida del schema, en principio no. Ambos generan el JSON con funciones de serialización nativas que escapan correctamente. El riesgo aparece cuando existen filtros personalizados que modifican la salida, cuando el texto viene con entidades desde la base de datos, o cuando hay un segundo bloque de JSON-LD inyectado manualmente en la misma página.
¿Cuánto tardan en recuperarse los resultados enriquecidos tras corregirlo?
Depende de la frecuencia de rastreo de las páginas afectadas. Después de publicar la corrección conviene solicitar la indexación de las URL más importantes mediante la inspección de URL en Search Console, y monitorear el informe de mejoras durante las siguientes semanas. En sitios con rastreo frecuente el retorno suele ser rápido; en sitios con rastreo esporádico puede tomar varias semanas.
¿Debo revisar el DOM en el inspector o el código fuente?
Siempre el código fuente crudo servido por el servidor. El inspector de las herramientas de desarrollador muestra el DOM ya procesado por el navegador, que puede resolver visualmente entidades que en el archivo original siguen presentes. Es el error de diagnóstico más frecuente y lleva a concluir que el marcado está limpio cuando no lo está.
¿Cómo evito que el problema vuelva a aparecer?
Documenta dos reglas técnicas para tu equipo: nunca construir JSON concatenando cadenas, y nunca aplicar funciones de escapado de HTML sobre valores destinados a un contexto JSON. Añade la validación de datos estructurados al proceso de publicación en lugar de dejarla para auditorías puntuales, y revisa mensualmente el informe de mejoras de Search Console para detectar caídas escalonadas a tiempo.
Contenido relacionado
del ecosistema Webhexup.
Cerca de 20 años trabajando en SEO técnico con marcas de Colombia y Estados Unidos. Implemento y mantengo datos estructurados complejos en verticales financieros, legales y de comercio electrónico, donde un bloque de marcado mal formado no es un detalle estético sino la diferencia entre aparecer con estrellas y precios o aparecer como un enlace azul más.
Contacto: LinkedIn · WhatsApp +57 313 682 9935